Zero Trust для ИИ-агентов почти всегда пытаются строить с конца: с политик доступа, файрволов, систем обнаружения. А начинать надо с вопроса поскучнее и поважнее: сколько у вас вообще агентов и кто их запустил. Управлять тем, чего не видно, нельзя. Почти в каждой компании, с которой мы работаем, реальный список автономных ИИ-систем сильно расходится с тем, что держит в голове служба безопасности.
Хороший пример — это инцидент с METR, некоммерческой организацией, которая тестирует ИИ-модели. Атакующий нашёл персональный EC2-инстанс с агентным приложением, обошёл аутентификацию и за три недели откачал через украденный API-ключ 600 000 долларов в токенах. Внутренняя панель мониторинга при этом не показывала запросы, упёршиеся в лимит скорости, поэтому аномалия физически не попадала в поле зрения тех, кто должен был её заметить. Проблема тут не в сломанном контроле доступа. Проблема в том, что этого инстанса вообще не было в инвентаре систем, за которыми кто-то следил.
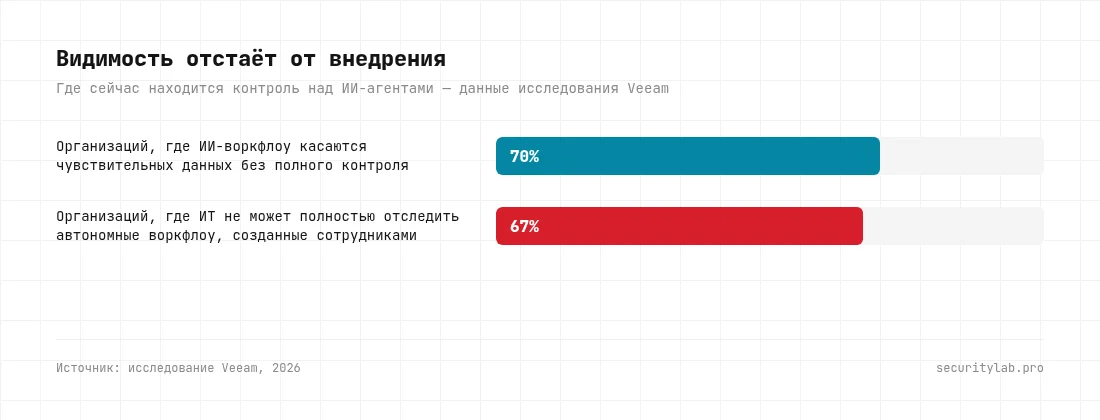
Три слепые зоны, из-за которых Zero Trust для агентов не работает
Мы регулярно проводим аудит безопасности ИИ-агентов и видим одну и ту же картину: организации перескакивают сразу к контролям, минуя этап видимости. Причина почти всегда одна из трёх.
Агенты как теневой ИТ
Внедрение агентов обгоняет управление ими на месяцы, иногда на годы. Разработчик подключает агентный SDK к внутреннему сервису в пятницу вечером, чтобы закрыть спринт. В понедельник у этого агента уже есть постоянный токен доступа к продовой базе, о котором не знает никто, кроме автора.
Первый инстинкт службы безопасности — заблокировать всё незнакомое. Но блокировка до того, как построен инвентарь, риск не убирает. Она выталкивает людей в обход политики, и агенты уходят в ещё большую тень, а не исчезают. Работает другой подход: считать сам факт трат на ИИ-инструменты сигналом к инвентаризации, а не нарушением. Появился в облачном биллинге или в логах API новый провайдер токенов, заведите на него карточку, а не открывайте разбирательство. И сразу дайте людям официальный быстрый путь получить одобренный инструмент, иначе обходной путь никуда не денется, просто станет незаметнее.
Слепые зоны на разных уровнях стека
Ни один отдельный источник телеметрии не видит весь парк агентов целиком. Агент может сидеть в сети, на эндпоинте, в браузере как расширение, внутри SaaS-интеграции. TLS-шифрование прячет от сетевого мониторинга сами промпты и вызовы инструментов.
Типичный пример: браузерное расширение суммирует данные клиентов из CRM и пишет черновики писем. Для EDR на эндпоинте оно невидимо, трафик к SaaS-домену зашифрован. Для атакующего — это готовый плацдарм: скомпрометированное расширение тянет данные из CRM, и ни одна из привычных защитных мер этого не замечает.
Закрывается это не одним инструментом, а корреляцией разнородных сигналов: DNS- и SNI-запросы, JA4-отпечатки TLS-соединений, переменные окружения на хостах, выданные OAuth-гранты, телеметрия самого браузера. По отдельности каждый сигнал слабый, вместе они складываются в реальную картину того, что агенты делают у вас в сети.
Разрыв между аудитом и реальностью
Годовой или даже квартальный аудит устаревает в момент публикации отчёта. Агентные системы клонируются, разворачиваются и уничтожаются за минуты. Короткоживущий клон агента способен появиться, выкачать данные и исчезнуть быстрее, чем пройдёт срок между двумя плановыми проверками, а атакующий, знающий цикл аудита конкретной организации, подгоняет темп атаки под паузы между ними.
Рабочий ответ здесь один: непрерывный мониторинг вместо точечного снимка. На практике это — система, которая постоянно наблюдает за агентами, включая агента, наблюдающего за другими агентами; регулярная проверка выданных прав, а не разовая сверка раз в год; именной владелец у каждого агента; и работающий kill switch, механизм экстренного отключения, который реально можно нажать посреди инцидента, а не только описать в регламенте.
Порядок действий, который реально работает
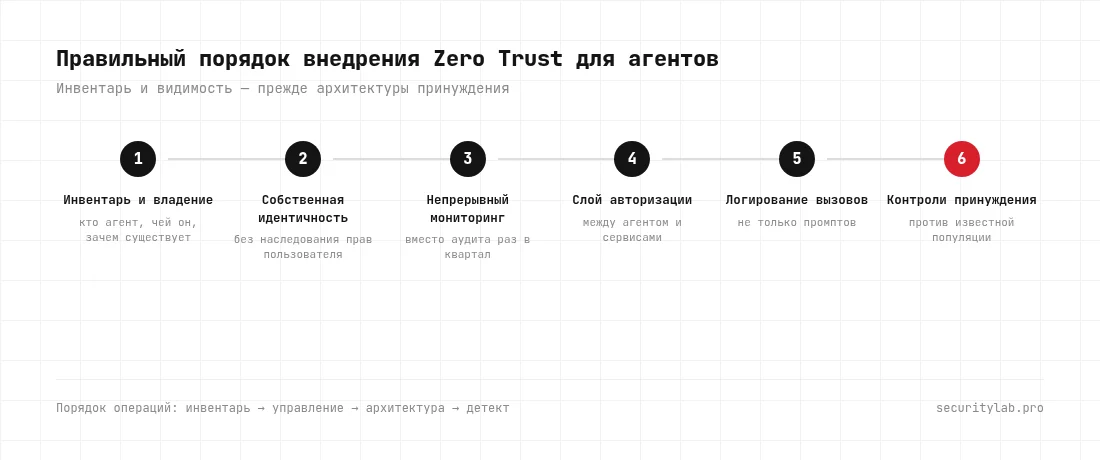
Правильная последовательность простая: сначала инвентарь и управление, затем защитные механизмы, и только потом системы обнаружения. Не наоборот. На практике это раскладывается на понятные шаги:
- Найти и занести в инвентарь всех агентов. Не «примерно представлять», а иметь список с владельцами, целью каждого агента и тем, к чему у него есть доступ.
- Дать агенту собственную идентичность. Агент не должен по умолчанию наследовать весь набор прав пользователя, который его развернул. Это одна из самых частых находок в наших аудитах безопасности инфраструктуры.
- Наладить непрерывный мониторинг вместо разовых проверок раз в квартал.
- Поставить слой авторизации между агентом и сервисами, к которым он обращается, вместо прямого прохода по унаследованным правам.
- Логировать не только промпты, но и сами вызовы инструментов. Что агент реально сделал, видно именно в вызовах, а не в тексте запроса.
- И только после этого разворачивать запретительные меры, и только против известного, заинвентаризированного набора агентов, а не вслепую против всего подряд.
Где в эту схему встают наши разработки
Мы разбираем эту проблему с разных сторон в своих материалах и продуктах, и она регулярно сводится к одному: идентичность и видимость агента важнее, чем попытка предсказать его поведение. Подробно мы писали об этом в разборе разбросанных секретов как проблемы нечеловеческих идентичностей.
За инвентарь и обнаружение агентов на периметре, включая чужих, у нас отвечает BastionAgent. Вместо того чтобы пытаться заранее заблокировать неизвестного агента, он расставляет мёртвые водяные креды и ловушки, понятные только системе, способной рассуждать. Сам факт взаимодействия агента с вашим периметром становится залогированным событием. Похожий сценарий мы разбирали на примере исследовательского агента, обошедшего контроль доступа государственного портала. Модель угрозы та же: агент, которому вообще не следовало туда попадать, стал виден только в момент действия.
Для собственных агентов, способных уйти в разнос на исходящей стороне, работает наш файрвол Airlock: он не даёт агенту слить данные или воспользоваться кредами, к которым тот не должен был прикасаться, независимо от того, предсказали вы такое поведение заранее или нет.
Сама фаза обнаружения и оценки — часть более широкой наступательной дисциплины. Мы уже писали, почему одна модель не покрывает и половины картины, и наша разработка AI Brain строилась вокруг этой идеи: маршрутизировать задачи между разными моделями и собирать находки в одну картину, а не полагаться на единственный источник правды. Если утечка или закрепление в системе уже произошли, дальше работа переходит к реагированию на инциденты, а встроить эту дисциплину в CI/CD и в сами пайплайны разработки агентов с самого начала помогает DevSecOps-аудит.
Вывод
Zero Trust для ИИ-агентов — это не набор политик, который настроил один раз и забыл. Это дисциплина, и начинается она со скучного, немодного вопроса «сколько у нас вообще агентов и кто их владелец», а к защитным механизмам и системам обнаружения переходит только потом. Организации, которые пытаются перепрыгнуть сразу к блокировкам и алертам, повторяют историю METR: контроль, может, и стоял, но никто не смотрел туда, где реально шла утечка. Начните с инвентаря, дайте каждому агенту собственную идентичность и владельца, наладьте постоянный, а не разовый контроль, и уже после этого добавляйте запреты и автоматическое реагирование.