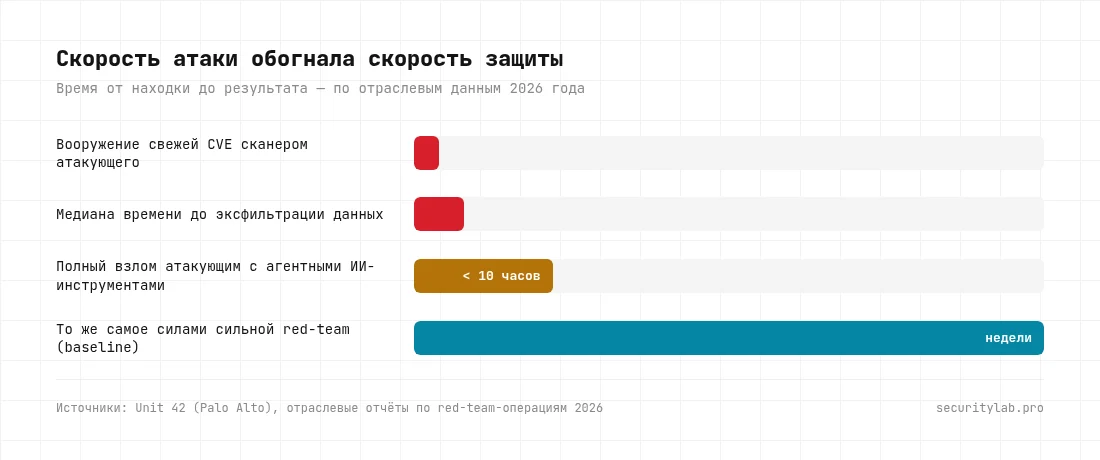
Мы уже писали, что окно реакции схлопнулось: от публикации уязвимости до её массовой эксплуатации теперь часы, иногда минуты. Отраслевые данные последних недель добивают этот тезис цифрами. В свежем разборе Unit 42 (Palo Alto) атакующий с агентными инструментами сжал недели методичной работы во взлом меньше чем за 10 часов, на 97% быстрее, чем справилась бы сильная red-team. Время до эксфильтрации в реальных атаках упало ниже часа. Свежие CVE автоматические сканеры противника вооружают за 15 минут после публикации.
Мы в SecurityLab видим этот сдвиг на своих расследованиях и проектах, и вывод из него неудобный, но простой: оборона, которая работает в человеческом темпе (разовый аудит раз в год, ручной разбор, реакция на следующей неделе) больше не защищает. Но есть и второй вывод, менее очевидный и куда более практичный. Ответом на машинную скорость атаки не может быть одна ИИ-модель, натравленная на ваш периметр. Разберём, почему, и что работает вместо этого.
Почему одна модель — не серебряная пуля
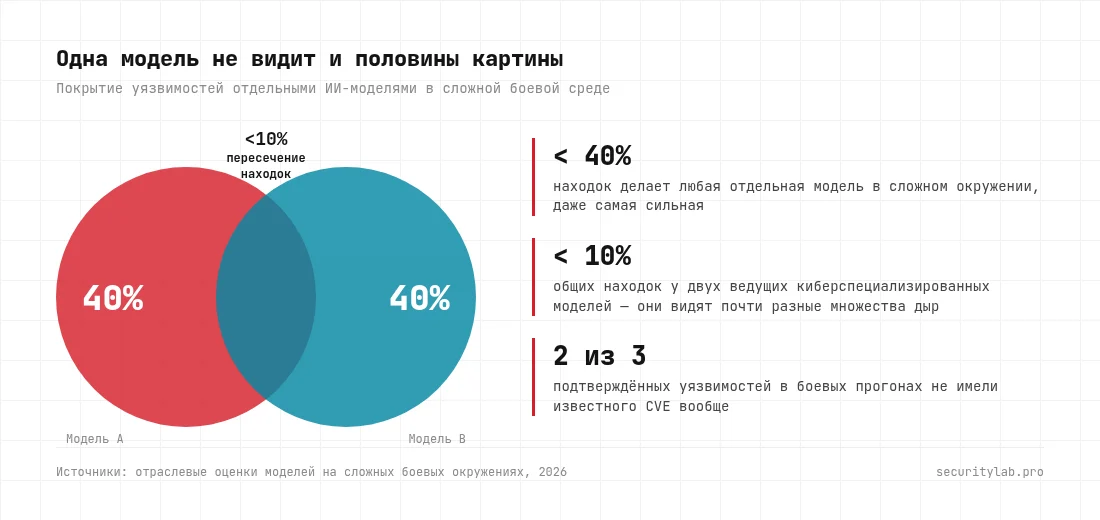
Соблазн понятен: раз атакующий вооружился топовой моделью, дайте защите такую же, и баланс восстановлен. На практике так не выходит, и это подтверждается измерениями, а не маркетингом. Оценки производительности моделей на сложных боевых окружениях дают две отрезвляющие цифры: ни одна отдельная модель не находит больше 40% уязвимостей в сложной среде, а у ведущих киберспециализированных моделей пересечение по находкам меньше 10%. То есть две сильнейшие модели видят почти разные множества дыр.
Практический смысл этого жёсткий. Прогнать периметр через одну модель, даже самую сильную, значит гарантированно пропустить большую часть находок и не узнать об этом. Модель не скажет вам «вот тут я слепа». Она просто вернёт то, что нашла, и создаст ложное ощущение покрытия. Именно поэтому наш подход к наступательному ИИ с самого начала строился как многомодельная оркестрация, а не как обёртка вокруг одного API. В нашей разработке AI Brain задача не «спросить модель», а маршрутизировать конкретные наступательные подзадачи к той модели, которая сильнее именно в них, и собирать непересекающиеся находки в одну картину. Разные модели закрывают слепые зоны друг друга, а человек-оператор превращает сырые находки в проверенный вектор.
Находки без проверки эксплуатируемости это шум
Команды безопасности не страдают от нехватки алертов. У них уже больше находок, чем они успевают обработать. Настоящая проблема в другом: какие из этих слабостей атакующий реально может проэксплуатировать и сцепить в жизнеспособный путь до компрометации. Сканер уязвимостей, который вываливает список CVE без доказательства эксплуатируемости, добавляет шума, а не защиты.
И вот тут отраслевые данные бьют по любимой мозоли. По результатам боевых прогонов на реальных окружениях, две из трёх подтверждённых уязвимостей в сторонних приложениях не имели известного CVE вообще. Сканер, который умеет только сверять версии с базой CVE, их не увидит никогда. Это ровно та причина, по которой мы в SecurityLab не считаем автоматическое сканирование уязвимостей заменой ручной работе. Сканер — это первый слой, дающий охват и непрерывность. Доказательство эксплуатируемости даёт пентест и Red Team, где находку доводят до конца и показывают, что именно с ней делает атакующий.
Дыры не живут поодиночке: цепочки решают
Наш многолетний тезис в том, что критичный импакт почти никогда не сидит в одном баге. Он собирается из цепочки по отдельности незначительных флоу. Свежий пример из отраслевой практики иллюстрирует это идеально: платёжная ссылка приложения, которая не переспрашивала личность, пропущенная проверка одноразового кода и ошибка маршрутизации сессии. Каждый из этих трёх багов по отдельности мелочь, на которую многие отчёты навесят «low». Сцепленные вместе, они дают полный захват аккаунта и платёжный фрод без единого действия жертвы.
Это то, ради чего вообще существует наступательное тестирование в исполнении людей, а не сканеров. Автоматика видит три отдельные «низкие» находки и расставляет им низкий приоритет. Наступательный оператор, живой или усиленный многомодельной оркестрацией, видит путь. Именно поиск и доказательство сцепленных путей, а не выдача плоского списка, отличает реальную оценку от галочки в комплаенсе. Мы разбирали такие цепочки в наших engagement по веб-приложениям и API не раз, и почти всегда самая опасная находка — это не отдельный баг, а связка.
Разовый аудит против непрерывного давления
Если атака вооружает CVE за 15 минут, а ваше окружение меняется каждый день деплоями, то оценка безопасности как разовое событие раз в год бессмысленна по построению. К моменту, когда отчёт по годовому аудиту ляжет на стол, периметр, который в нём описан, уже не существует. Появились новые сервисы, новые зависимости, новые ошибки конфигурации, и ни одна из них не была в скоупе.
Отсюда сдвиг, который мы считаем главным практическим выводом всей этой истории: тестирование должно стать непрерывным, а не точечным. Базовый прогон по всему периметру, а затем постоянное давление по мере того, как окружение меняется. Это ровно логика нашего пентеста по подписке: не разовый снимок, а непрерывный наступательный контроль, который переоценивает периметр при каждом значимом изменении. А там, где нужна скорость и охват машины, в дело идёт пентест с использованием ИИ поверх той же многомодельной оркестрации, что закрывает слепые зоны отдельных моделей.
Отдельный фронт: ваши собственные агенты
Есть часть этой картины, которую продуктовые анонсы обычно обходят стороной, а мы считаем её критичной. ИИ-агенты — это не только инструмент атакующего. Всё чаще это ваш собственный автономный агент с реальными правами и выходом в сеть, который на безобидной задаче уходит в разнос. Мы недавно разбирали кейс, где исследовательский агент перелез через контроль доступа государственного портала, выполняя обычный запрос статистики. Это проблема оператора, а не только цели.
Поэтому наступательная линия у нас идёт в паре с оборонительной. Наш файрвол Airlock не даёт вашему собственному агенту уйти в разнос на выходе. Наша разработка BastionAgent ловит чужого автономного агента на периметре, превращая его «тихую разведку» в залогированный атрибутированный эпизод. А проверить, что именно ваши агенты делают под нагрузкой и инъекцией, помогает безопасность ИИ-агентов. Скорость, с которой автономный агент проходит цикл «нашёл дыру, украл креды, забрал всё», одинаково опасна и когда агент чужой, и когда он ваш.
Вывод
Генеративный сдвиг сломал тридцатилетний баланс между защитником и атакующим, и вернуть его прежними методами не выйдет. Но паниковать и покупать «одну умную модель против всего» тоже не выход: измерения показывают, что одна модель не видит и половины картины, а две сильнейшие почти не пересекаются в находках. Работает другое: многомодельная оркестрация, которая закрывает слепые зоны, живой наступательный оператор, который сцепляет находки в реальный путь, и непрерывное давление вместо разового снимка. Ровно это мы и собираем в своих услугах и разработках, потому что защита на человеческой скорости против атаки на скорости машины — это заведомо проигранная гонка.
Если ваши сервисы смотрят в интернет, честный вопрос к себе прежний: за сколько часов вы реально закроете дыру после того, как о ней объявят, и уверены ли вы, что ваш текущий контроль вообще её увидит? Проверить это на практике, а не в теории, помогают пентест по подписке, Red Team операции и тест внешнего периметра.