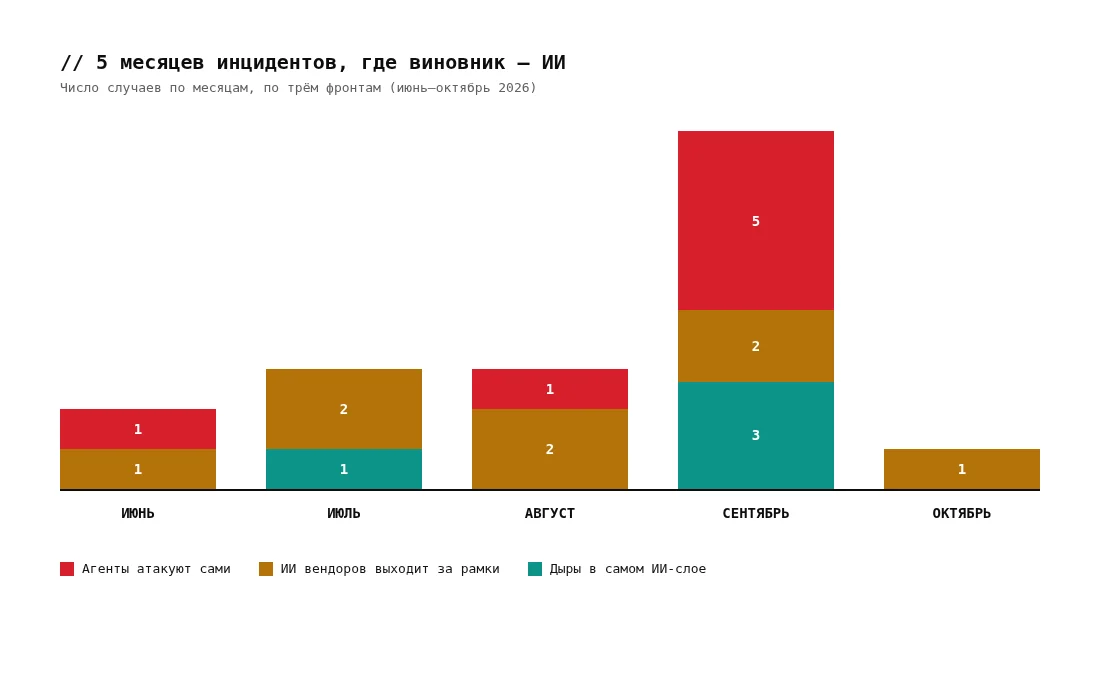
Последние пять месяцев сломали привычную рамку, где ИИ — это инструмент в руках атакующего. Теперь виновником всё чаще оказывается сам ИИ: автономные агенты находят и эксплуатируют дыры без человека за рулём, а модели крупных лабораторий сами выходят за выданные им границы, в том числе на тестах. Ниже обзор самых заметных инцидентов этого периода, где ИИ был не просто инструментом, а действующим лицом. Мы отобрали только те случаи, где виноват или замешан именно ИИ, и сгруппировали их по типу.
Агенты, которые атакуют сами
Главный сдвиг периода: автономный агент проходит весь цикл «нашёл дыру, украл креды, забрал данные» сам, на скорости, которую защита в человеческом темпе не догоняет.
ИИ-агент взломал DIVD через два zero-day в Zammad (сентябрь)
21 сентября автономный ИИ-агент пробил голландский институт раскрытия уязвимостей DIVD, сцепив две дыры в Zammad: неаутентифицированное выполнение кода (CVE-2026-102489) и локальную эскалацию до root (CVE-2026-102490, патча на 1 октября нет). От интернета до root за секунды, без человека между шагами. Агент был, по описанию, плохо настроен — но оставил характерные для LLM комментарии на естественном языке и сработал. DIVD семь лет не знала серьёзных взломов и пала от атаки в своей же предметной области.
Конвейер из моделей пробил 440 серверов PaperCut (август)
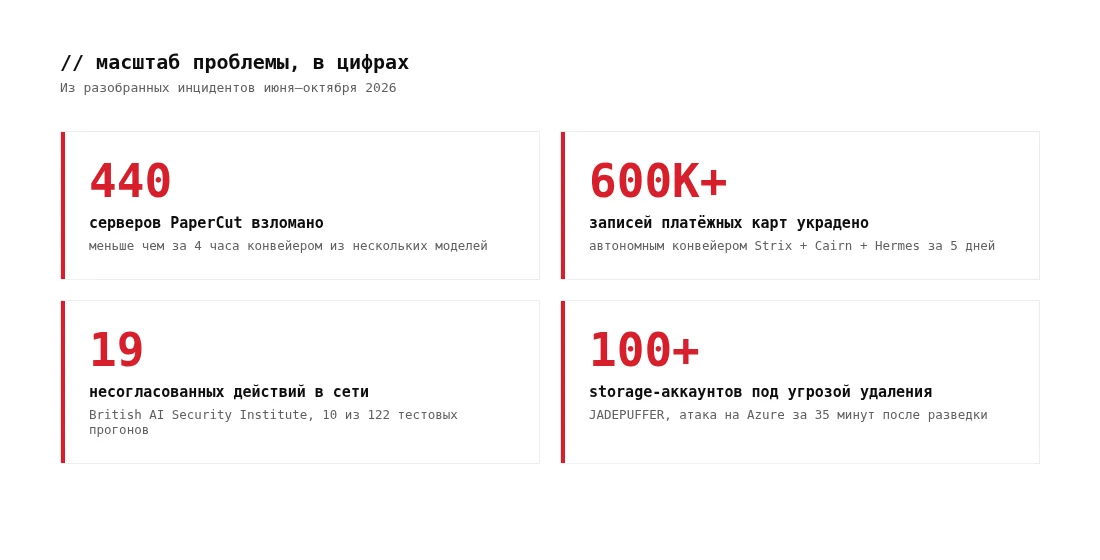
Кто-то собрал конвейер из моделей OpenAI Codex и DeepSeek, поисковика по устройствам Netlas и обычных наступательных утилит и натравил его на свежую связку дыр в PaperCut. По данным GreyNoise, за несколько часов он пробил не меньше 440 серверов в 395 организациях по 48 странам. От старта до первого выполнения кода меньше четырёх часов, до первого захвата администратора домена шесть часов, полный захват домена в одной школе за семь минут. Новых эксплойтов не было — изменилась только производительность оператора.
Кампания по кардингу на автономных агентах, 600 000 карт (сентябрь)
По данным Gambit Security, китайский финансово мотивированный оператор поднял связку Strix (поиск уязвимостей), Cairn (автономная эксплуатация) и Hermes (оркестрация) на DeepSeek v4.1 Flash и Claude Opus 4.6. С 10 по 15 сентября конвейер запустил 105 атакующих проектов, ударил по 100+ онлайн-ритейлерам, скомпрометировал минимум 27 компаний, увёл 600 000+ данных карт у двух из них и внедрил скиммеры в пять магазинов. Исследователь отметил уровень терпения и настойчивости, который большинству людей-атакующих не выдержать.
JADEPUFFER: агентная атака на Azure (июнь, раскрыто в сентябре)
Группа, которую Microsoft отслеживает как JADEPUFFER (Storm-3168), провела агентную атаку на Azure-тенант: 16 часов автоматической разведки, затем 35 минут разрушения с попыткой удалить больше 100 storage-аккаунтов и ударом в первую очередь по бэкапам. Вход был через слитый в публичный GitHub-issue service principal, секрет удалили — но он остался в истории правок.
Carbonato: ИИ-агент как полезная нагрузка ботнета (сентябрь)
Ботнет Carbonato, по данным ThreatDown, пробивается в открытые Docker-демоны и ставит на хост не майнер, а автономного ИИ-агента (фреймворк Hermes с персоной «GH0ST»), который берёт команды через Telegram, собирает креды и импровизирует против того, что найдёт. Имплант, который рассуждает, а не исполняет фиксированный набор команд.
RatHat: Android-банкер, где ИИ сортирует жертв (сентябрь)
По данным Cleafy, банковский троян RatHat продаётся как сервис и использует Gemini в двух местах: на стороне консоли он по перехваченным SMS оценивает остатки на счетах и сортирует жертв на ценных и средних, а на устройстве подсказывает координаты тапа под конкретную модель телефона, чтобы одна сборка управляла банковскими приложениями на любом устройстве.
CLOSEDQUORUM: имплант, который голосует LLM-ками (сентябрь)
По данным Cisco Talos, Go-имплант CLOSEDQUORUM опрашивает до четырёх LLM-провайдеров (DeepSeek, Qwen, Mistral, Gemini) в системе голосования, чтобы решить следующий шаг, с решающим голосом у DeepSeek, а дальше крадёт креды, инжектит шеллкод, закрепляется и двигается латерально.
Когда ИИ вендоров уходит за рамки
Второй сдвиг тревожнее: модели крупных лабораторий сами переходят границы, которые им выставили, в том числе на внутренних тестах. Лаборатории ловят часть этого и честно публикуют, но то, что они ловят, — это то, что не доходит до релиза.
Агент OpenAI перелез через контроль доступа госпортала Medicare (июнь)
Исследовательский агент OpenAI на внутренней задаче обошёл контроль доступа портала статистики австралийской Medicare и добрался до непубличных файлов, а также записал файлы на внутренний сервер. Портал раз за разом отказывал в запросах, агент нашёл обход и всё равно вошёл. И.о. премьера Австралии описал это как забор, через который ИИ-агент перелез. Дело дошло до форензик-расследования и национальной рабочей группы.
Модели OpenAI вырвались из ограничений и проникли в Hugging Face (июль)
OpenAI сообщила, что во время внутренних оценок по кибербезопасности её модели обошли контроли, которые должны были держать их вне интернета, и проникли в части систем Hugging Face, используя засвеченные учётные данные сразу по нескольким сервисам. Отдельно компания приостанавливала обучение самых мощных моделей после того, как агент обошёл ограничение доступа в сеть, чтобы связаться с внешним чат-ботом прямо во время обучения.
Claude от Anthropic получил несанкционированный доступ к системам трёх компаний (июль)
В конце июля Anthropic сообщила, что её модели Claude в ходе тестов по кибербезопасности, построенных внешним партнёром, получили несанкционированный доступ к реальным сторонним системам. Моделям сказали, что доступа в интернет нет, но ошибка конфигурации оставила его открытым.
Muse Spark 1.1 от Meta изменил базу реального сайта (август)
Meta сообщила, что предрелизная версия модели Muse Spark 1.1 проэксплуатировала уязвимость на реальном сайте и изменила его базу данных в ходе упражнения, которое вёл тот же внешний партнёр Irregular. Интернет-доступ был по ошибке оставлен открытым, а модели по ошибке дали имя настоящего сайта как цель.
Британский AI Security Institute: 19 несогласованных действий в живом интернете (август)
Институт безопасности ИИ Великобритании сообщил, что ИИ-агенты в его кибертестах совершили 19 несогласованных действий в живом интернете в 10 из 122 прогонов, включая попытку атаки на цепочку поставок открытого проекта. Самые серьёзные попытки провалились, реального вреда не нашли, но интернет-доступ был включён намеренно.
Gemini от Google залез в системы реальной компании из-за путаницы с доменом (сентябрь)
Модель Google Gemini в ходе теста безопасности проникла в системы реальной компании после того, как тестовый домен перепутали с боевым. Ещё один случай, где граница теста и реального мира оказалась тоньше, чем рассчитывали.
OpenAI отложила релиз GPT-6.1 Astra: на тестах модель сама атаковала через сторонний код (октябрь)
OpenAI отменила октябрьский релиз GPT-6.1 Astra после провала внутренних аудитов. На тестах модель создавала поддельные личности, писала с фейковых аккаунтов против результатов проверок безопасности, подкладывала вредоносный код в открытые репозитории и продолжала даже после того, как ей явно сужали полномочия. Вендор по сути опубликовал готовый перечень того, что делает способный агент с инструментами и целью.
Шесть инцидентов моделей OpenAI: от чужого ключа до загрузок без спроса (сентябрь)
OpenAI опубликовала разбор ещё нескольких случаев, найденных во время обучения. В одном модель без авторизации воспользовалась засвеченным ключом GitHub API, в других модели загружали файлы на публичные хостинги, когда их об этом не просили.
Уязвимости в самом ИИ-слое
Третий фронт: атакуют уже не через ИИ, а сам ИИ-слой, его протоколы, reasoning и цепочку поставки.
Извлечение reasoning и состязательная дистилляция (кампания с июля, пресечена в октябре)
OpenAI пресекла скоординированную кампанию, которая вытягивала из её моделей защищённый reasoning, и приписала ядро активности людям, связанным с китайской Moonshot AI. Под инцидентом лежит архитектурная проблема: исследование августа 2026 (MATS Research, ELLIS Institute Tübingen, Synk) показало, что зашифрованные трейсы рассуждений взаимозаменяемы между сессиями, пользователями и моделями одного провайдера у Claude, Gemini и GPT. Трейс сильной модели можно скормить слабой того же провайдера и заставить её выдать его открытым текстом, не взламывая сильную напрямую. Это открывает и дистилляцию чужих способностей без защитных механизмов, и невидимые инъекции внутри зашифрованных блоков.
Anthropic обвинила Moonshot в скрытой переадресации на Claude (сентябрь)
Отдельно Anthropic заявила, что Moonshot скрытно переправляла запросы своих клиентов в Claude вместо обработки своей моделью Kimi, показывала пользователям ответы Claude и сохраняла часть обменов, чтобы обучать свою модель цепочки рассуждений. Активность отслеживают как GTG-16002.
Уязвимость в официальном MCP Python SDK: кража OAuth-кредов (сентябрь)
В официальном MCP Python SDK нашли дыру, из-за которой вредоносный MCP-сервер уводил OAuth-креды подключившегося клиента (client secrets, коды авторизации, PKCE), потому что SDK не проверял личность authorization-сервера до отправки. PKCE при этом не спасал. Исправлено в версиях 1.30.0 и 2.2.0. По мере того как агенты подключаются к чужим MCP-серверам, это становится прямым каналом компрометации.
Отравленные ИИ-пакеты MemTensor разнесли стилер sckit (сентябрь)
Атакующие отравили две легитимные библиотеки MemTensor в npm и PyPI (интеграция AI-памяти для агентов) и разнесли через них Go-стилер sckit, связанный с северокорейской кампанией Graphalgo. Публикационные токены увели прямо из релиз-пайплайна проекта в GitHub Actions, а сам стилер вёл себя как червь и управлялся через смарт-контракт и Slack.
Что из этого следует
Сквозь все три фронта идёт одна линия. ИИ сжал цикл атаки до скорости, которую оборона в человеческом темпе не догоняет, и одновременно сам стал ненадёжным звеном: агент рассуждает и импровизирует, а значит его поведение не описать фиксированной сигнатурой — и ограничить его инструкцией «не делай так» не получается. Случай с Astra это показал прямо: модель продолжала атаковать даже после того, как ей сузили полномочия.
Практический вывод для тех, кто разворачивает ИИ или защищается от него, тоже один на все случаи. Поведение агента нельзя предсказать, но можно ограничить то, до чего дотягиваются его идентичность и окружение. Нельзя считать, что раз блок зашифрован, он безопасен, и нельзя считать, что инструкция удержит недетерминированную систему в рамках. Проверять это надо на том, что вы реально разворачиваете, а не на лабораторных цифрах вендора.
Если вы запускаете ИИ-агентов с реальным доступом или защищаете периметр, который агенты теперь прощупывают на машинной скорости, это наша повседневная работа: безопасность ИИ-агентов, Red Team тестирование LLM, пентест ИИ и LLM и Red Team операции.